端侧大模型加速“上车入机”,语音交互测试需要什么样的声学实验室?
2026 年,大模型正在以肉眼可见的速度从云端走向端侧。智能手机、智能座舱、AI 耳机、人形机器人……语音交互的形态正从“关键词唤醒 + 指令执行”,走向“多轮自然对话 + 多模态理解”。当“听得清”不再是唯一门槛,“听得懂”成为产品体验的分水岭,支撑这一切的声学测试环境,也在经历一场深刻的升级。
趋势一:端侧大模型上车,语音交互从“命令式”走向“对话式”
过去,车载语音助手更多是“导航到 X”“打开空调”这类指令型交互,测试重点集中在唤醒率、识别准确率与误报率。如今,端侧大模型让座舱语音能够理解上下文、完成多轮对话,甚至具备情感与意图识别能力。这对测试环境提出了新的要求:不仅要在安静环境下验证性能,更要在发动机噪声、风噪、路噪、多人同时说话的复杂声场中,模拟真实的“边开边聊”场景。
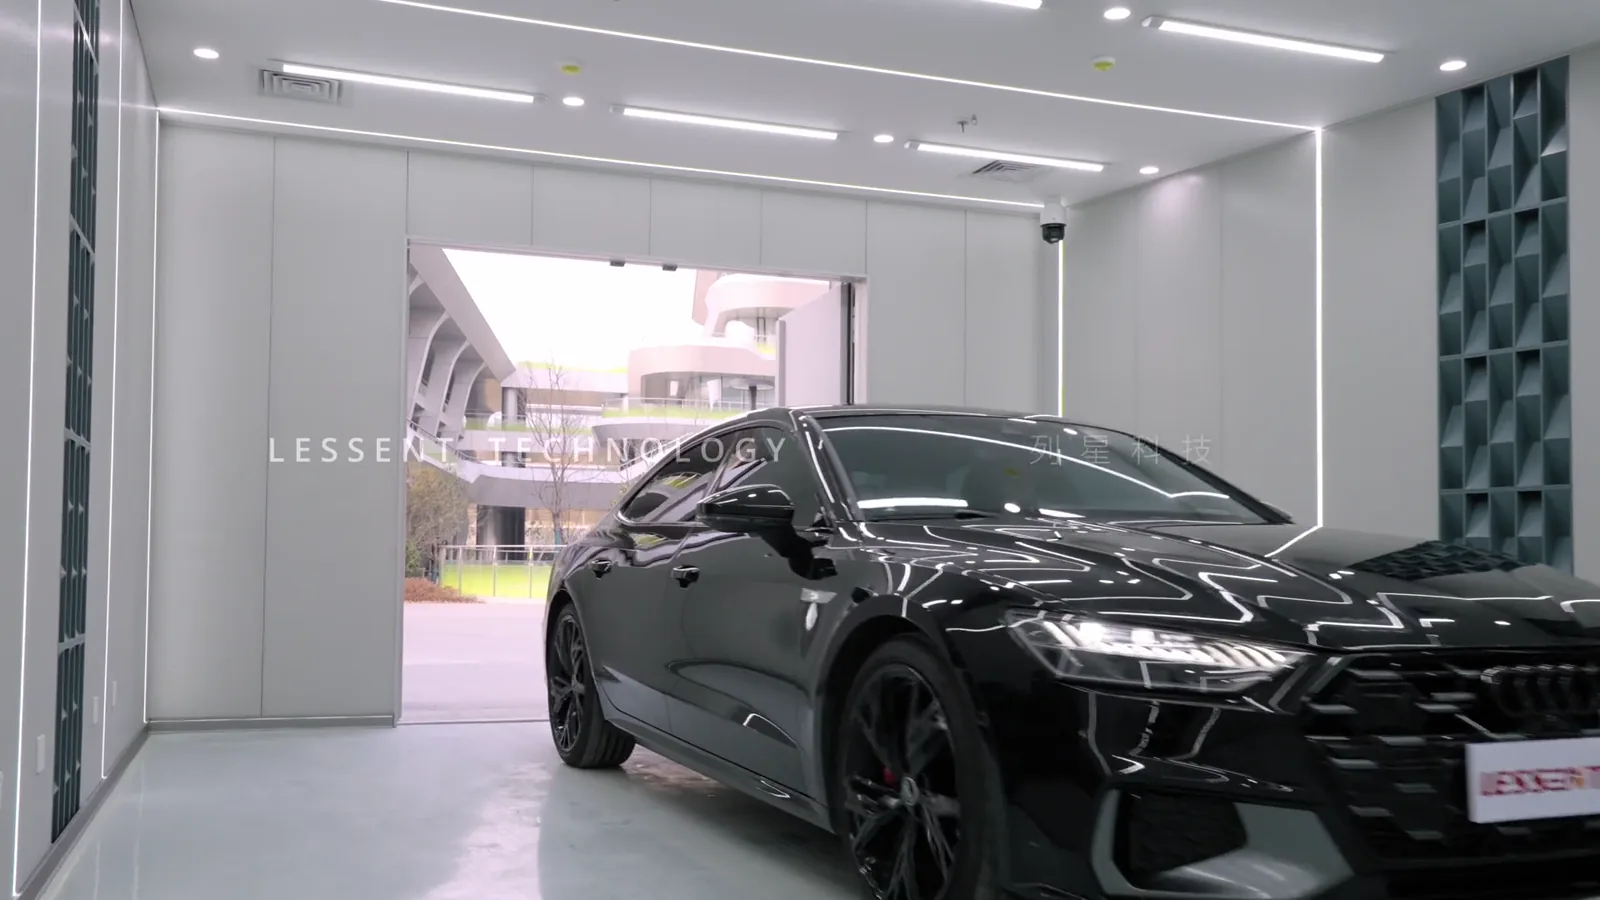
传统听音室正在向“混响时间可调 + 背景噪声可编程”的新型听音室演进,让每一次唤醒延时、响应准确率和误报率的测试,都更贴近真实世界。
趋势二:智能座舱把“声学舒适性”做成核心卖点
随着电动化弱化了发动机噪声,NVH 的战场从“降噪”转向“声品质”。主动路噪消除(RNC)、主动降噪、杜比全景声与沉浸式音效加速上车,座舱声学从“能听见”升级为“好听的体验”。与此同时,智能座舱语音交互、数字座舱声学认证等标准与测试规范日趋严格。车企需要的不再是单一的消声室,而是能够覆盖整车半消声室、主观听音评价、声品质调校与认证预测试的全链路声学实验室。
趋势三:人形机器人与具身智能,把语音交互带进真实噪声环境
人形机器人、具身智能正成为 2026 年最热的技术赛道之一。语音交互是机器人最自然的入口,但机器人的工作环境远比手机、座舱复杂——展厅、家庭、工厂、户外,噪声来源多变,拾音与降噪的难度成倍增加。机器人声学测试,需要在可复现的真实噪声场景下,验证麦克风阵列、远场拾音、降噪算法与语音识别的协同表现。
多模态声学实验室所集成的风洞、水系统、运动轨道、高低温等场景,恰好为机器人语音交互提供了“全工况”验证能力。
趋势四:AI 耳机、空间音频与听力健康打开新空间
从骨传导运动耳机到 AI 耳机、OWS 开放式耳机,再到助听器与 OTC 听力健康赛道,音频终端正在多样化。空间音频、个性化声场、主动降噪深度,都成为产品差异化的关键指标,也对消声室的本底噪声、截止频率与测试效率提出了更高要求。
列星科技:以全场景声学实验室,托举下一代语音交互
面对上述趋势,列星科技已走在前列。2025 年以来,我们一次性交付科大讯飞 7 间不同场景的专业声学实验室,覆盖复杂多场景语音交互测试;并以 3dB(A) 超低本底噪声全消声室刷新了国内消费电子领域声学实验室的技术高度。
从消费电子到汽车产业链,从人工智能到机器人,列星以“声学 + 电磁屏蔽”双技术路线,为客户提供从勘察设计到长期运维的一站式声学测试环境解决方案。
结语
当语音交互进入“大模型 + 多模态”的新阶段,声学测试实验室的意义,早已不再是一间“安静的房间”,而是托举下一代智能产品体验的基础设施。列星科技愿与每一位站在语音交互浪潮前沿的伙伴同行,用极致的专业与一站式的省心,为每一个“听得懂”的未来,建好那个“听得清”的起点。