智能眼镜声学测试迎来国家“标尺”:JJF 2385—2026 正式实施,AI 可穿戴的“耳朵”进入标准化时代
进入 2026 年 10 月,AI 可穿戴领域多了一把“尺子”。
10 月 2 日,市场监管总局发布的 JJF 2385—2026《智能眼镜声学性能测试规范》国家计量技术规范正式实施。这是国内首个针对智能眼镜声学性能的统一技术标尺,由全国声学计量技术委员会(MTC13)归口制定,围绕“收音”与“放音”两大模块,建立起标准化的检测流程,重点划定三项关键评价维度:收音与播放的频率响应、麦克风收音的指向性响应,以及声压级与自生噪声。
当智能眼镜从“尝鲜玩具”变成 AI 的核心入口,它的“耳朵”与“嘴巴”——麦克风与扬声器——终于有了一张全国统一的考卷。
一、为什么是智能眼镜的“声学”被单独立规
过去两年,智能眼镜加速从“概念”走向“上脸”。华为、联想先后发布 AI 智能眼镜,小米 AI 眼镜蓄势待发,Meta 与谷歌 Gemini 的 AI 眼镜路线图被排到 2026,亚马逊也在扩大智能眼镜的导航等应用场景。AI 大模型把“语音”重新推到了可穿戴交互的中心——戴上眼镜说一句话,就能完成翻译、导航、拍照、问答。
但声学性能恰恰是智能眼镜长期“说不清”的一环:麦克风拾音清不清楚、扬声器回放还不还原、嘈杂环境下人声分不分得开、底噪压不压得住,此前都缺少全国统一的技术标尺。企业各自对标、消费者无从判断,行业呼唤一张标准化的考卷。
二、“收音”与“放音”:新标尺量了什么
JJF 2385—2026 把智能眼镜的声学性能拆成“收音”与“放音”两大模块来测。
收音与播放的频率响应,衡量录音、回放对声音的还原度,要求贴近人耳真实的听觉感受;麦克风收音的指向性响应,检验拾音方向与定位能力,这正是复杂场景下“听得清、分得开”的关键;声压级与自生噪声,则关乎响度与底噪的控制。
在计量上,规范也给出了明确的精度要求——频率响应、指向性响应和声压级修约到 0.1 dB,自生噪声修约到 1 dB,测量不确定度按 JJF 1059.1 执行。这意味着智能眼镜的声学性能,从此可以被统一、可追溯、可对标地测量与比较。
三、从标准到产业:声学成为智能眼镜的胜负手
标准落地背后,是产业已经把声学当作智能眼镜的“胜负手”。
在 2026 年 3 月的 GAS2026 中国国际音频产业大会上,歌尔股份以“声态+AI”为主题,展出智能眼镜全栈声学解决方案,并首次推出智能眼镜双路语音分离算法,直指复杂环境下双向对话与翻译中“人声混叠、AI 识别不准”的行业痛点。而在 10 月的 ACM UbiComp/ISWC 2026 上,清华大学与蚂蚁集团的联合研究则把话题推到更深处:智能眼镜的语音安全认证,不能只回答“是谁在说话”,还要判断“这个声音是不是佩戴者现场发出的”。
一句话:智能眼镜的声学,正在从“能听到”升级为“听得清、听得准、防得住”。而这三件事,都必须在可复现、可计量、可对标的声学环境里被一遍遍验证。
四、列星科技能做什么
作为深耕高精度声学实验室的专业服务商,列星科技长期为消费电子、人工智能、汽车产业链、半导体通讯以及高校科研机构、第三方检测机构提供整体解决方案。智能眼镜声学测试标准的落地,恰好落在列星的能力区间上:
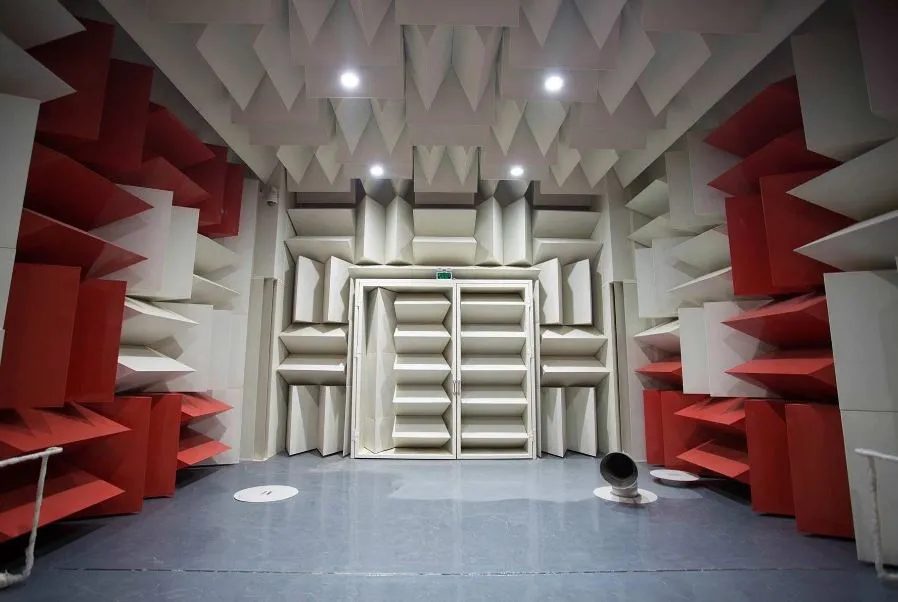
- **消声室 / 半消声室**:本底噪声低至 3 dB(A)/5 dB(A),为麦克风、扬声器与自生噪声测量提供最干净的标定基准;
- **可变混响听音室**:一键复现“安静、嘈杂、多人、强反射”等真实使用声场,验证唤醒延时、响应准确率、误报率与指向性拾音效果;
- **语音交互实验室**:面向语音助手、翻译、声纹安全认证等 AI 场景,搭建标准化、可对标的测试环境;
- **多模态声学实验室**:集成风噪、运动、高低温等多元场景,还原佩戴者在真实环境中的全工况声学表现。
从服务华为、OPPO、三星、微软、联想、大疆等全球顶尖客户,到与歌尔声学、安克创新、科大讯飞等产业链伙伴的深度合作,列星始终站在声学测试环境建设的一线。如今,当智能眼镜的“耳朵”有了国家标准,列星愿与每一位把“听清、听懂”做成核心体验的可穿戴企业同行。